Observatoire des fautes d'orthographe
Quelles fautes les élèves font-ils réellement, et à quel niveau ? La méthode de mesure est décrite ci-dessous ; les résultats seront publiés niveau par niveau dès que le seuil d'anonymat sera atteint.
L'observatoire mesure la fréquence des erreurs d’orthographe détectées automatiquement par niveau scolaire, à partir des dictées corrigées automatiquement sur le site. Chaque erreur détectée est classée dans l'une des sept familles d'erreur et les résultats sont exprimés en fautes pour 100 mots dictés, une fois le seuil d'anonymat atteint.

Pourquoi mesurer les familles de fautes plutôt que leur nombre
Les familles d’erreur décrivent les catégories attribuées par la correction automatique dans les dictées observées. Les taux pour 100 mots facilitent la lecture de ce corpus, mais dépendent des textes, des participants et du classement automatique.
Ces résultats ne permettent ni de diagnostiquer les difficultés d’un élève, ni de déduire l’effet du programme scolaire, ni de promettre une durée de remédiation. Pour choisir une révision, examinez aussi les productions de l’élève et les conseils de son enseignant.
Ce que ces chiffres ne disent pas
Trois limites méritent d'être posées clairement, parce qu'un chiffre sans ses limites se fait citer de travers.
L'échantillon n'est pas représentatif. Il décrit les élèves qui utilisent ce site — un échantillon auto-sélectionné dont la représentativité n’est pas établie. Ces données servent à comparer les familles d'erreurs entre elles, pas à estimer un niveau national.
La détection dépend de l'outil. Les fautes sont repérées et classées automatiquement. Le classement d'une faute ambiguë entre deux familles voisines — un accord manqué peut relever de l'accord ou de la conjugaison — comporte une part de convention.
Un taux n'est pas un jugement. Une famille très représentée décrit ce corpus seulement. Le choix des textes et le niveau des participants peuvent influencer les taux ; aucune causalité scolaire n’est établie.
Les résultats ne sont pas encore publiés
La mesure est en cours. Un niveau n'est publié qu'à partir de 30 élèves distincts : en dessous, un pourcentage pourrait décrire un enfant identifiable, et nous préférons ne rien afficher plutôt qu'un chiffre fragile.
La méthodologie complète est décrite ci-dessous et ne changera pas rétroactivement : les résultats publiés plus tard auront été calculés exactement de cette façon.
La méthode de mesure
Publiée intégralement, parce qu'un chiffre dont on ignore le mode de calcul ne vaut pas grand-chose.
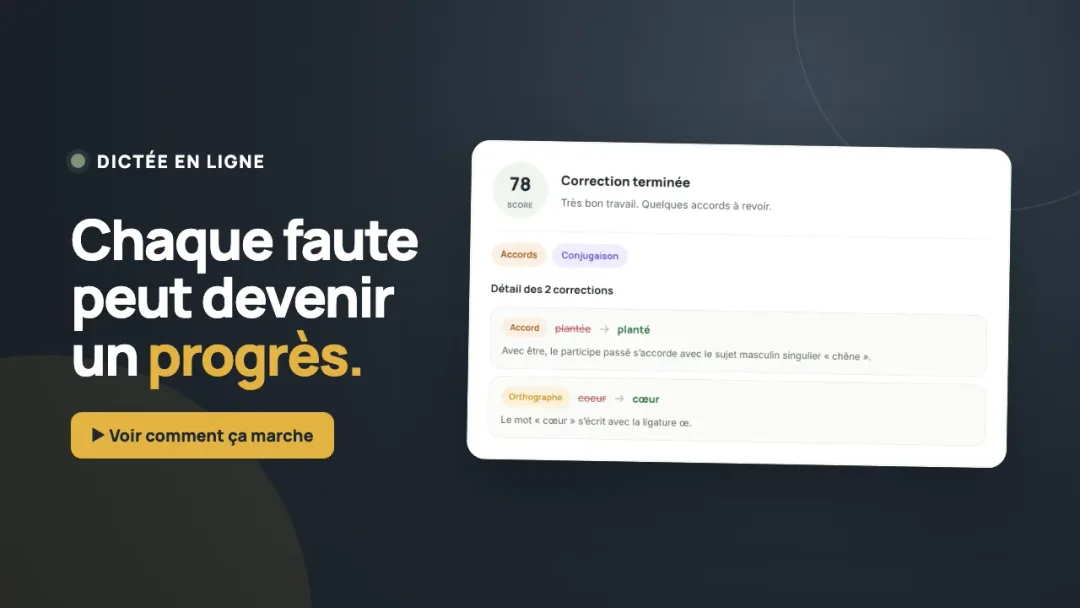
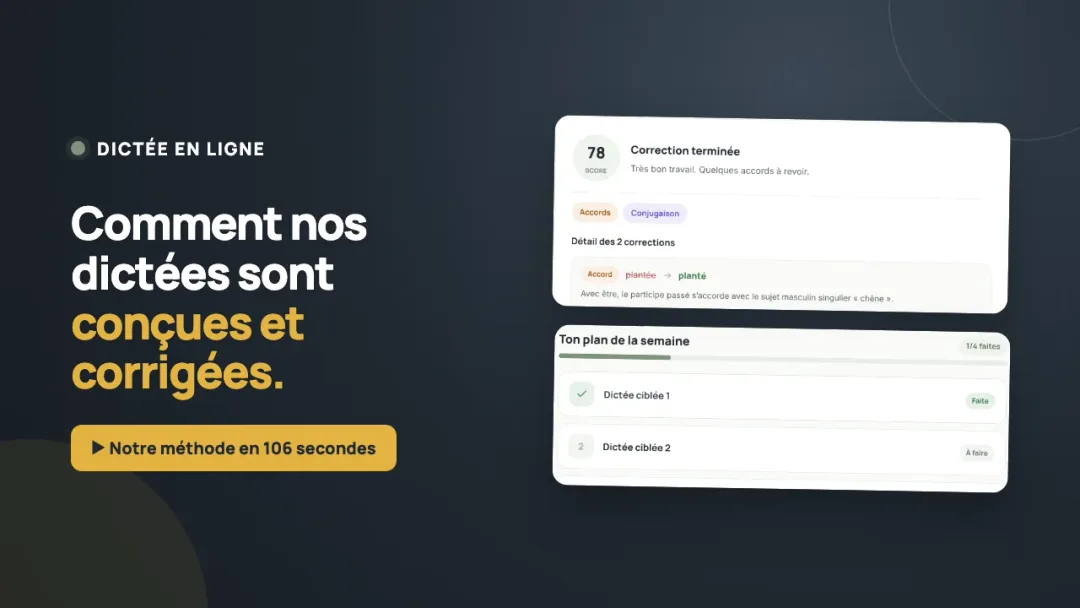
Chaque dictée soumise est corrigée automatiquement. La correction produit une liste de fautes, chacune étiquetée par famille : accord, conjugaison, orthographe lexicale, homophone, accent, ponctuation ou majuscule.
Une fois par jour, les corrections de la veille sont agrégées par niveau et par famille. Seuls des compteurs sont conservés : nombre de fautes, nombre de dictées, nombre d'élèves distincts, nombre de mots dictés.
Un niveau n'est publié qu'au-delà de 30 élèves distincts. En dessous, les résultats sont supprimés, pas arrondis : un arrondi laisserait subsister une information sur un effectif trop petit.
Les taux sont exprimés en fautes pour 100 mots dictés, sur l'ensemble des mots du niveau. Les catégories qui n'apparaissent jamais restent affichées à zéro plutôt que masquées, pour que l'absence soit lisible.
Questions fréquentes
D'où viennent ces données ?
Comment la confidentialité est-elle protégée ?
Que signifie « fautes pour 100 mots » ?
Ces chiffres sont-ils représentatifs des élèves français ?
À quelle fréquence les données sont-elles mises à jour ?
Réutiliser ces données
Ces statistiques sont librement réutilisables sous licenceCC BY 4.0, à condition de citer « Dictée en ligne » avec un lien vers cette page. Les niveaux comptant moins de 30 apprenants distincts sont exclus des exports.
Intégrer le graphique
Travailler une famille de fautes
Rédigé et relu par L'équipe pédagogique Dictée en ligne. Mis à jour le 26 septembre 2026. Notre méthode pédagogique détaille comment chaque contenu est conçu et vérifié.
Connaître la répartition des fautes de votre enfant
Une dictée corrigée propose un classement des erreurs détectées. Relisez les explications pour choisir une notion à réviser.
Créer un compte gratuit